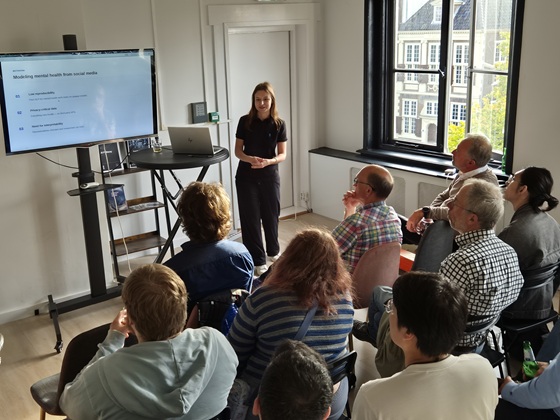
AI-systemen kunnen veranderingen in signalen rond mentale gezondheid herkennen in tijdlijnen op sociale media. Maar voor toepassingen in de zorg is alleen nauwkeurigheid niet genoeg. Tijdens een bijeenkomst van de Leiden AI Community presenteerde onderzoeker Maryia Zhyrko van de Universiteit Leiden een aanpak waarin lokale taalmodellen, op regels gebaseerde methoden en traditionele machinelearning worden gecombineerd. Zo moet de analyse transparanter en reproduceerbaarder worden, met meer aandacht voor privacy.
De analyse van mentale gezondheid is een steeds belangrijker toepassingsgebied voor natuurlijke taalverwerking (NLP). Maar het gebruik van AI voor zeer persoonlijke gegevens brengt ook problemen met zich mee, vooral rond privacy, uitlegbaarheid en betrouwbaarheid. Tijdens de Leiden AI Community presenteerde masterstudent Computer Science Maryia Zhyrko onderzoek naar een hybride aanpak die juist met die beperkingen rekening houdt.
Zhyrko richt zich in haar onderzoek op natuurlijke taalverwerking, klinische NLP, computationele sociale wetenschappen en generatieve AI. Haar presentatie draaide om DreamerNLplus, een raamwerk voor het analyseren van tijdlijnen op sociale media. Het systeem probeert veranderingen in signalen rond mentale gezondheid in de loop van de tijd te herkennen, terwijl gevoelige informatie lokaal blijft.
Het onderzoek werd uitgevoerd voor een gezamenlijke onderzoekstaak en gepresenteerd tijdens ACL. Het systeem kijkt niet alleen of een afzonderlijk bericht een positief of negatief sentiment bevat. Het probeert diepere psychologische toestanden te herkennen en vooral te bepalen hoe die zich ontwikkelen in een reeks berichten.
Verder kijken dan de black box
Een belangrijk doel van het project was om de werking van het systeem inzichtelijk te maken. Volgens Zhyrko kampt onderzoek naar NLP en mentale gezondheid met problemen rond reproduceerbaarheid. Bovendien maken ondoorzichtige modellen het voor zorgverleners en onderzoekers lastig om te begrijpen hoe een voorspelling tot stand komt.
Het team koos er daarom bewust voor niet op één black-boxmodel te vertrouwen. In plaats daarvan combineerden de onderzoekers verschillende technieken, waaronder herkenning op basis van regels, een random-forestmodel, classificatiemodellen en lokaal draaiende opensourcetaalmodellen. Het doel was om afzonderlijke voorspellingen controleerbaar te maken en ze waar mogelijk te voorzien van een begrijpelijke uitleg.
Privacy speelde eveneens een belangrijke rol bij deze keuze. Berichten op sociale media en klinische verslagen kunnen zeer gevoelige persoonlijke informatie bevatten. Daarom draaiden de taalmodellen lokaal, in plaats van gegevens naar externe AI-diensten te sturen.
Het systeem verdeelde de analyse in drie stappen: het bepalen van iemands huidige psychologische toestand, het herkennen van veranderingen tussen verschillende toestanden in de loop van de tijd en het samenvatten van die ontwikkelingen.
Signalen herkennen in afzonderlijke berichten
In de eerste stap classificeerden de onderzoekers psychologische kenmerken in afzonderlijke berichten. Sommige toestanden kwamen maar weinig voor en de beschikbare testgegevens bestonden uit slechts dertig dialogen. Daarom werd ook een lokaal taalmodel gebruikt om synthetische trainingsdata te maken.
Vervolgens vergeleek het team classificatie met machinelearning met een transparantere aanpak op basis van regels. Bij die tweede methode werden kenmerkende woorden en uitdrukkingen uit de aangevulde dataset gehaald en gekoppeld aan bepaalde toestanden. Nieuwe berichten konden daarna met deze taalkundige kenmerken worden vergeleken.
Dat heeft een voordeel voor de uitlegbaarheid: onderzoekers kunnen rechtstreeks zien welke formuleringen hebben bijgedragen aan een bepaalde classificatie. Zhyrko noemde bijvoorbeeld uitingen van vermoeidheid of terugtrekgedrag als mogelijke signalen van een niet-helpende psychologische toestand.
Het onderzoek liet ook zien dat er een belangrijk verschil bestaat tussen het herkennen van een toestand en het bepalen van de intensiteit ervan. Een systeem kan goed herkennen welk type psychologische toestand in een tekst naar voren komt, maar tegelijkertijd moeite hebben om te bepalen hoe sterk die toestand aanwezig is.
Volgens Zhyrko hadden modellen die goed presteerden bij het herkennen van specifieke subcategorieën vaak meer moeite met het inschatten van de algemene intensiteit. Beide problemen kunnen daarom niet zonder meer als dezelfde modeltaak worden behandeld.
Herkennen wanneer er iets verandert
Het tweede deel van het systeem richtte zich op veranderingen in de tijd. Voor ieder nieuw bericht kreeg een lokaal taalmodel zowel het actuele bericht als de vijf voorgaande berichten te zien. Daarnaast kreeg het voorbeelden met labels voor verschillende soorten veranderingen. Vervolgens genereerde het model zowel een classificatie als een korte uitleg van de redenering.
De onderzoekers vergeleken deze aanpak met een traditioneel model dat gebruikmaakte van onder meer tekstrepresentaties, veranderingen ten opzichte van eerdere berichten en sentimentsignalen. Beide methoden bleken andere zwakke punten te hebben.
Het taalmodel herkende meer mogelijke veranderingen. Daardoor was de recall relatief hoog, maar de precisie lager. Bij de aanpak zonder taalmodel was het beeld omgekeerd: die leverde minder fout-positieve resultaten op, maar had meer moeite met het herkennen van zeldzame psychologische toestanden.
Een lastig punt was het onderscheid tussen geleidelijke achteruitgang en een plotselinge verandering. Bij een reeks berichten waarin het gedrag steeds negatiever wordt, is een duidelijke ontwikkeling zichtbaar. Een plotselinge verbetering of verslechtering zonder duidelijke aanwijzingen in eerdere teksten is veel moeilijker betrouwbaar te herkennen.
Ook de beperkte omvang van de dataset maakt het lastig om harde conclusies te trekken. Met slechts dertig tijdlijnen zijn vooral zeldzame veranderingen moeilijk te modelleren, aldus Zhyrko.
Regels tegenover generatieve samenvattingen
De derde taak bestond uit het samenvatten van ontwikkelingen over een volledige tijdlijn. Hiervoor vergeleken de onderzoekers twee duidelijk verschillende methoden.
De eerste was een deterministisch samenvattingssysteem op basis van regels. Dit systeem beoordeelde reeksen berichten, koos vooraf vastgelegde sjablonen en stelde daaruit een vaste beschrijving samen.
Het voordeel daarvan is voorspelbaarheid. Omdat het systeem met sjablonen werkt en niet vrij tekst genereert, zijn de resultaten reproduceerbaar en wordt het risico op verzonnen informatie door generatieve AI beperkt.
Bij de tweede aanpak genereerde een taalmodel rechtstreeks een samenvatting op basis van de onderliggende berichten. Relevante voorbeelden uit de trainingsdata werden daarbij automatisch opgehaald om het model richting te geven.
Hier ontstond een bekende afweging bij AI-systemen. De aanpak op basis van regels bood meer controle en consistentie, terwijl het taalmodel flexibelere samenvattingen kon maken. In de evaluatie van de gezamenlijke onderzoekstaak presteerde de aanpak met het taalmodel goed op maatstaven voor tekstuele overeenkomst. De samenvattingen op basis van regels scoorden juist sterk op interne samenhang.
Volgens Zhyrko legt dit een breder probleem bij de evaluatie bloot. Maatstaven die kijken naar de overeenkomst met door mensen geschreven referentieteksten belonen niet noodzakelijk dezelfde eigenschappen als maatstaven die logische consistentie beoordelen.
Patronen tussen verschillende gebruikers
De onderzoekers probeerden daarnaast patronen te vinden die in meerdere tijdlijnen terugkwamen.
Om te voorkomen dat het taalmodel te veel informatie tegelijk moest verwerken, werden de tijdlijnen in groepen verdeeld. Een lokaal model zocht eerst naar terugkerende patronen binnen iedere groep. In een tweede stap werden deze bevindingen samengevoegd tot een algemener patroon.
Deze aanpak presteerde vooral goed bij het herkennen van verbetering. In de evaluatie eindigde het systeem als eerste in de categorie verbetering en als derde bij verslechtering. Volgens Zhyrko kan een mogelijke verklaring zijn dat verslechterende psychologische toestanden vaak minder eenduidig zijn en daardoor moeilijker consequent te classificeren.
Uit de verschillende experimenten kwam echter geen methode naar voren die op alle criteria het beste presteerde. Een verbetering op de ene maatstaf ging regelmatig ten koste van de prestaties op een andere. Het herkennen van afzonderlijke veranderingen, het bewaken van de samenhang in de tijd en het maken van heldere samenvattingen blijken deels tegenstrijdige doelen.
Mogelijke rol in klinisch onderzoek
Zhyrko wees ook op verschillende beperkingen. Synthetische gegevens geven mogelijk niet alle nuances van echte verhalen over mentale gezondheid weer. Bovendien werkt het systeem als een keten van opeenvolgende stappen. Daardoor kunnen fouten in een vroeg stadium doorwerken in latere analyses.
Het systeem kan daarom beter worden gezien als onderzoek naar uitlegbare beslisondersteuning dan als een geautomatiseerd diagnostisch hulpmiddel.
Mogelijke toepassingen die tijdens de presentatie werden genoemd, zijn het ondersteunen van onderzoekers en zorgverleners bij het analyseren van sessieverslagen, het herkennen van veranderende patronen tussen klinische contactmomenten en het bieden van een open systeem waarvan de conclusies kunnen worden gecontroleerd en beoordeeld.
Volgens Zhyrko is de bredere ontwikkeling dat NLP voor mentale gezondheid steeds dichter bij praktische toepassingen in de zorg komt. In zo’n omgeving is alleen de uitkomst van een model niet genoeg. Onderzoekers en zorgverleners moeten kunnen begrijpen waarom een systeem tot een bepaalde conclusie komt. Tegelijkertijd vraagt het werken met gevoelige persoonlijke verhalen om stevige bescherming van de privacy.
Een belangrijk vraagstuk blijft de manier waarop zulke systemen worden beoordeeld. De huidige maatstaven voor samenhang, consistentie in de tijd en tekstuele overeenkomst kunnen verschillende, soms zelfs tegenstrijdige eigenschappen belonen. Een belangrijke volgende stap is daarom het ontwikkelen van een meer samenhangende evaluatiemethode, die niet alleen kijkt naar statistische prestaties maar ook naar de bruikbaarheid in de klinische praktijk.
De presentatie laat daarmee een bredere ontwikkeling binnen toegepaste AI zien. In gevoelige domeinen hoeft het grootste of meest complexe model niet automatisch het nuttigst te zijn. Door taalmodellen te combineren met eenvoudigere en beter controleerbare technieken kan een evenwicht ontstaan tussen flexibiliteit, privacy, reproduceerbaarheid en uitlegbaarheid.