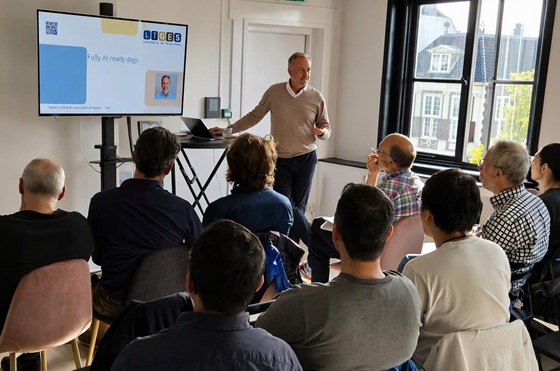
Bij de Leiden AI Community sprak gisteren FAIR-data-pionier Barend Mons. Hij betoogde dat de volgende stap in kunstmatige intelligentie niet zozeer afhangt van steeds grotere modellen, maar vooral van de kwaliteit, betekenis en toegankelijkheid van de data erachter. Zijn antwoord is een infrastructuur waarin machines data kunnen begrijpen, algoritmen naar gevoelige datasets toe gaan in plaats van dat de data worden verplaatst, en conceptuele modellen AI-systemen helpen om aannemelijke antwoorden te onderscheiden van statistische gokjes.
Tijdens zijn presentatie voor de Leiden AI Community greep Barend Mons terug op een idee dat al bestond vóór de huidige opmars van generatieve AI: data begrijpelijk maken, niet alleen voor mensen maar ook voor machines. De moleculair bioloog en hoogleraar aan de Universiteit Leiden en het Leids Universitair Medisch Centrum was een van de grondleggers van de FAIR-databeweging. Die ontwikkelde de principes om data vindbaar, toegankelijk, uitwisselbaar en herbruikbaar te maken: Findable, Accessible, Interoperable and Reusable.
Voor Mons heeft bij FAIR echter altijd vooral één aspect centraal gestaan: machines moeten zelfstandig met de data kunnen werken. Hij vat dat eenvoudig samen: ‘de machine weet wat ik bedoel’. In de praktijk betekent dit dat begrippen, structuren en onderlinge relaties in een dataset een duidelijk omschreven betekenis hebben, zodat software die kan interpreteren zonder dat daar steeds een mens aan te pas hoeft te komen.
Door de snelle opkomst van grote taalmodellen is dat belangrijker geworden. Volgens Mons blijven zelfs geavanceerde AI-systemen afhankelijk van de kwaliteit van de informatie die ze krijgen. Slecht gestructureerde, dubbelzinnige of onjuiste data kunnen zich via AI-systemen verspreiden en leiden tot onbetrouwbare uitkomsten en hallucinaties.
Van FAIR naar Fully AI Ready
Mons omschrijft FAIR data daarom steeds vaker als Fully AI Ready. Als een machine een FAIR digitaal object tegenkomt, moet die volgens hem zelfstandig drie vragen kunnen beantwoorden: wat is het, wat kun je ermee en wat mag een mens of machine ermee doen? Die vragen hebben respectievelijk betrekking op het type object, metadata over de mogelijke analyses en metadata over regels en rechten rond het gebruik.
Dat onderscheid is vooral belangrijk in sectoren als de zorg en de levenswetenschappen. Daar kan terminologie meerdere betekenissen hebben en kan veel waardevolle informatie niet zomaar openbaar worden gemaakt.
Mons illustreerde dit aan de hand van afkortingen en biologische begrippen die verschillende betekenissen kunnen hebben. Mensen leiden uit de context vaak vanzelf af wat ermee wordt bedoeld. Voor computers moet die betekenis expliciet worden vastgelegd. AI-modellen hebben volgens hem daarom meer nodig dan alleen enorme hoeveelheden tekst. Ze hebben ook betrouwbare semantische informatie nodig die duidelijk maakt wat begrippen betekenen en hoe ze met elkaar samenhangen.
Een van de benaderingen die tijdens de presentatie aan bod kwam, is de combinatie van AI met grote kennisgrafen en conceptuele modellen. Mons verwees naar onderzoek binnen de levenswetenschappen waarbij gebruik wordt gemaakt van een graaf met ongeveer 4,5 miljard zogeheten triples, afkomstig uit wetenschappelijke publicaties en zorgvuldig samengestelde databases. Zo’n model kan grenzen stellen aan mogelijke relaties tussen begrippen en helpen beoordelen of een door AI gegenereerde bewering semantisch aannemelijk is.
Dat betekent niet dat speculatieve uitkomsten helemaal moeten worden uitgesloten. Volgens Mons kan de strengheid van zulke filters afhangen van de toepassing. Bij wetenschappelijk onderzoek kan het juist nuttig zijn om ruimte te laten voor ongebruikelijke hypotheses. Een operationeel systeem dat wordt ingezet in een situatie met grote risico’s vraagt daarentegen om veel strengere grenzen.
Zo ontstaat wat Mons omschrijft als een vorm van hybride intelligentie: machines herkennen patronen en genereren mogelijkheden, terwijl gestructureerde kennis zorgt voor context en grenzen.
Verplaats algoritmen, niet de data
Een tweede belangrijk onderwerp in de presentatie was de toegang tot data. Vooral in de zorg, bij farmaceutisch onderzoek en in andere sterk gereguleerde omgevingen beschikken organisaties over waardevolle informatie die niet zomaar naar een centrale database kan worden gekopieerd.
Volgens Mons moeten we daarom de stap maken van data delen naar data bezoeken.
In dit model blijven gegevens binnen een FAIR Data Station dat onder controle staat van de eigenaar of beheerder. Een algoritme gaat naar de data toe, voert daar lokaal een analyse uit en stuurt alleen het toegestane resultaat terug. De onderliggende dataset hoeft de organisatie niet te verlaten.
De toegang kan op verschillende momenten worden gecontroleerd. Een bezoekend algoritme vraagt eerst toestemming, krijgt vervolgens toegang tot specifiek aangewezen gegevens en voert zijn taak uit in een gecontroleerde omgeving. Daarna kan de organisatie controleren welk resultaat het algoritme wil terugsturen en dit zo nodig blokkeren.
Mons gaf als voorbeeld farmaceutisch onderzoek naar bijwerkingen. In plaats van patiëntendossiers over te dragen, kan een goedgekeurd algoritme ziekenhuisgegevens bezoeken en een nauwkeurig afgebakende vraag stellen. Bijvoorbeeld: hoeveel patiënten kregen een bepaald medicijn, hoeveel van hen hadden een specifieke bijwerking en hoeveel behoorden tot een bepaalde leeftijdsgroep? De aanvrager krijgt vervolgens alleen het geaggregeerde antwoord, niet de onderliggende patiëntgegevens.
Deze aanpak moet het mogelijk maken om gevoelige datasets te gebruiken voor analyses, terwijl de beheerders zeggenschap houden over de gegevens. Hetzelfde principe kan ook ver buiten de zorg worden toegepast. Mons noemde tijdens zijn presentatie onder meer natuurhistorische collecties, de Rotterdamse haven en overheidsorganisaties als mogelijke toepassingsgebieden.
Een internet voor machines
Mons vergeleek de voorgestelde architectuur met de ontwikkeling van het internet. In plaats van iedere toepassing of ieder onderdeel van de infrastructuur vooraf vast te leggen, kan een relatief kleine verzameling gemeenschappelijke protocollen ervoor zorgen dat verschillende systemen met elkaar communiceren.
LIFES, het Leiden Initiative for FAIR and Equitable Science, moet de verschillende partijen samenbrengen die nodig zijn om zo’n ecosysteem op te bouwen. Het gaat onder meer om organisaties die data beheren, leveranciers van toepassingen en diensten, AI-bedrijven en vakinhoudelijke gemeenschappen die standaarden en implementatieprofielen voor hun eigen domein vaststellen.
Op langere termijn is het doel wat Mons een ‘Internet of FAIR Data and Services’ of een ‘Living Evidence Engine’ noemt: een gedistribueerde omgeving waarin machines relevante bronnen kunnen vinden, de betekenis ervan begrijpen, toegang kunnen regelen en analyses kunnen uitvoeren, zonder dat alle informatie eerst op één centrale plek hoeft te worden verzameld.
Voor AI-bedrijven kan zo’n infrastructuur een oplossing bieden voor een van de hardnekkigste obstakels bij het ontwikkelen van bruikbare modellen: toegang tot hoogwaardige data voor training en validatie. Mons stelde tot slot dat LIFES mechanismen wil helpen ontwikkelen waarmee bedrijven gecontroleerd toegang kunnen krijgen tot zulke gegevens, terwijl de eigenaren van de data zeggenschap houden over het gebruik ervan.
De boodschap aan de Leiden AI Community was daarmee dat betrouwbare AI niet alleen draait om het model. Ook steeds krachtigere algoritmen hebben data nodig waarvan de betekenis duidelijk is, waarvan de herkomst kan worden vastgesteld en waarvan het gebruik goed kan worden geregeld. In de visie van Mons kan het machineleesbaar en direct bruikbaar maken van die basis uiteindelijk net zo belangrijk worden voor de AI-infrastructuur als de modellen die erop draaien.